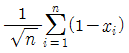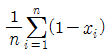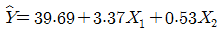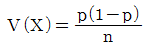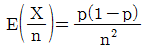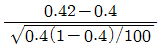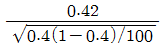사회조사분석사 2급 필기 기출문제복원 (2018-04-28)

사회조사분석사 2급 2018-04-28 필기 기출문제 해설

이 페이지는 사회조사분석사 2급 2018-04-28 기출문제를 CBT 방식으로 풀이하고 정답 및 회원들의 상세 해설을 확인할 수 있는 페이지입니다.

사회조사분석사 2급
(2018-04-28 기출문제)

목록

1과목: 조사방법론 I

1. 과학적 지식에 가장 가까운 것은?

  1. 절대적 진리
  2. 개연성이 높은 지식
  3. 전통에 의한 지식
  4. 전문가가 설명한 지식
(정답률: 78%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

2. 다음 중 조사대상의 두 변수들 사이에 인과관계가 성립되기 위한 조건이 아닌 것은?

  1. 원인의 변수가 결과의 변수에 선행하여야 한다.
  2. 두 변수간의 상호관계는 제3의 변수에 의해 설명되면 안 된다.
  3. 때로는 원인변수를 제거해도 결과변수도 존재 할 수 있다.
  4. 두 변수는 상호연관성을 가져야 한다.
(정답률: 76%)
  • 인과관계가 성립하려면 원인이 결과보다 앞서야 하고, 두 변수 간 상관관계가 있어야 하며, 제3의 변수로 설명되지 않아야 합니다. 또한 원인이 제거되면 결과도 나타나지 않아야 하므로, 원인변수를 제거해도 결과변수가 존재할 수 있다는 설명은 인과관계의 조건에 어긋납니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

3. 사회과학적 연구의 일반적인 연구목적과 가장 거리가 먼 것은?

  1. 사건이나 현상을 설명(Explanation)하는 것이다.
  2. 사건이나 상황을 기술 또는 서술(Description)하는 것이다.
  3. 사건이나 상황을 예측(Prediction)하는 것이다.
  4. 새로운 이론(Theory)이나 가설(Hypothesis)을 만드는 것이다.
(정답률: 67%)
  • 사회과학적 연구의 일반적인 목적은 현상을 정확하게 기술(Description)하고, 그 원인을 설명(Explanation)하며, 이를 바탕으로 미래의 상황을 예측(Prediction)하는 것입니다. 새로운 이론이나 가설을 만드는 것은 연구의 과정이나 결과물일 수 있으나, 연구 그 자체의 일반적인 목적과는 거리가 멉니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

4. 가설에 관한 설명으로 틀린 것은?

  1. 가설은 과학적 검증방법을 통하여 가설의 옳고 그름을 판단할 수 있어야 한다.
  2. 가설은 동일 연구 분야의 다른 가설이나 이론과 연관이 없어야 한다.
  3. 가설은 두 개 이상의 구성개념이나 변수 간의 관계에 대한 진술이다.
  4. 가설은 반드시 검증 가능한 형태로 진술되어야 한다.
(정답률: 88%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

5. 다음 중 탐색적 연구를 하기 위한 방법으로 가장 적합한 것은?

  1. 횡단연구
  2. 유사실험연구
  3. 시계열연구
  4. 사례연구
(정답률: 78%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

6. 개념(Concepts)의 정의와 가장 거리가 먼 것은?

  1. 일정한 관계사실에 대한 추상적인 표현
  2. 특정한 여러 현상들을 일반화함으로써 나타나는 추상적인 용어
  3. 현상을 예측 설명하고자 하는 명제, 이론의 전개에서 그 바탕을 이루는 역할
  4. 사실과 사실 간의 관계에 논리의 연관성을 부여하는 것
(정답률: 58%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

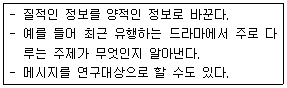
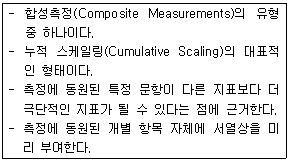
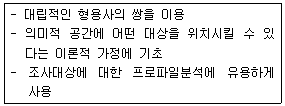
7. 다음과 같은 특징을 지닌 연구방법은?

  1. 투사법
  2. 내용분석법
  3. 질적 연구법
  4. 사회성측정법
(정답률: 81%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

8. 면접원이 자유 응답식 질문에 대한 응답을 기록할 때 지켜야할 원칙과 가장 거리가 먼 것은?

  1. 면접조사를 진행한 이후 최종응답을 기록한다.
  2. 응답자가 사용한 후 어휘를 원래 그대로 기록한다.
  3. 질문과 관련된 모든 것을 기록에 포함시킨다.
  4. 같은 응답이 반복되더라도 가감 없이 있는 그대로 기록한다.
(정답률: 80%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

9. 다음 중 정치지도자나 대기업경영자 등 조사대상자의 명단은 구할 수 있으나 그들을 직접 만나기는 매우 어려운 경우 가장 적합한 자료수집방법은?

  1. 면접조사
  2. 집단조사
  3. 전화조사
  4. 우편조사
(정답률: 66%)
  • 조사 대상자의 명단은 확보 가능하지만, 사회적 지위가 높아 직접 대면하거나 실시간 통화 시간을 내기 어려운 경우, 응답자가 원하는 시간에 자유롭게 작성할 수 있는 우편조사가 가장 적합합니다.

    오답 노트

    면접조사, 집단조사: 직접 만남이 필수적이므로 부적합
    전화조사: 바쁜 대상자의 경우 통화 거절 가능성이 높고 응답 시간이 제한적임
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

10. 양적조사와 질적조사의 사례로 틀린 것은?

  1. 질적조사 – 사례연구의 기록을 분석하여 핵심적인 개념을 추출한다.
  2. 양적조사 – 단일사례조사로 청소년들이 흡연 횟수를 3개월 동안 주기적으로 기록한다.
  3. 질적조사 – 노숙인과 함께 2주간 생활하면서 참여 관찰한다.
  4. 양적조사 – 초점집단면접을 통해 문제해결방안을 도출한다.
(정답률: 72%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

11. 실험설계(Experimental Design)의 타당성을 높이기 위한 외생변수 통제방법이 아닌 것은?

  1. 제거(Elimination)
  2. 균형화(Matching)
  3. 성숙(Maturation)
  4. 무작위화(Randomization)
(정답률: 78%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

12. 집합단위의 자료를 바탕으로 개인의 특성을 추리할 때 저지를 수 있는 오류는?

  1. 알파 오류(α-Fallacy)
  2. 베타 오류(β-Fallacy)
  3. 생태학적 오류(Ecological Fallacy)
  4. 개인주의적 오류(Individualistic Fallacy)
(정답률: 84%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

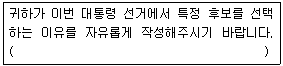
13. 다음에 제시된 설문지 질문유형의 특징이 아닌 것은?

  1. 탐색적인 연구에 적합하다.
  2. 질문내용에 대한 연구자의 사전지식을 많이 필요로 하지 않는다.
  3. 응답자에게 창의적인 자기표현의 기회를 줄 수 있다.
  4. 응답자의 어문능력에 관계없이 이용이 가능하다.
(정답률: 72%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

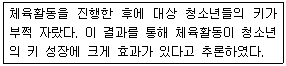
14. 다음 사례에서 영향을 미칠 수 있는 대표적인 타당도 저해요인은 무엇인가?
  1. 성숙효과(Maturation Effect)
  2. 외부사건(History)
  3. 검사효과(Testing Effect)
  4. 도구효과(Instrumentation)
(정답률: 79%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

15. 질적 방법으로 수집된 자료에 관한 설명으로 틀린 것은?

  1. 정보의 심층적 의미를 파악할 수 있다.
  2. 유용한 정보의 유실을 줄일 수 있다.
  3. 현장중심의 사고를 할 수 있다.
  4. 자료의 표준화를 도모하기 쉽다.
(정답률: 85%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

16. 다음 중 질문문항의 배열에 관한 설명으로 틀린 것은?

  1. 시작하는 질문은 응답자의 흥미를 유발하는 곳으로 쉽게 대답할 수 있는 것으로 한다.
  2. 개인의 사생활과 같이 민감한 질문은 가급적 뒤로 돌린다.
  3. 특수한 것을 먼저 묻고, 일반적인 것을 그 다음에 질문한다.
  4. 논리적인 순서에 따라 배열함으로써 응답자 자신도 조사의 의미를 찾을 수 있도록 한다.
(정답률: 88%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

17. 다음 중 연구윤리에 어긋나는 것은?

  1. 연구 대상자의 동의 확보
  2. 연구 대상자의 프라이버시 확보
  3. 학술지에 기고한 내용을 대중서, 교양잡지에 쉽게 풀어쓰는 행위
  4. 이미 발표된 연구결과 또는 문장을 인용표시 없이 발췌하여 연구계획서를 작성
(정답률: 86%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

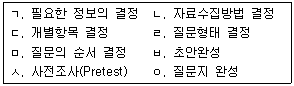
18. 질문지 작성의 일반적인 과정을 바르게 나열한 것은?(오류 신고가 접수된 문제입니다. 반드시 정답과 해설을 확인하시기 바랍니다.)
  1. ㄱ→ㄴ→ㄷ→ㄹ→ㅁ→ㅂ→ㅅ→ㅇ
  2. ㄱ→ㅁ→ㄴ→ㄹ→ㄷ→ㅂ→ㅅ→ㅇ
  3. ㄱ→ㄹ→ㄷ→ㄴ→ㅁ→ㅂ→ㅅ→ㅇ
  4. ㄱ→ㄴ→ㄹ→ㄷ→ㅁ→ㅂ→ㅅ→ㅇ
(정답률: 54%)
  • 질문지 작성은 정보 결정부터 최종 완성까지 체계적인 단계를 거칩니다.
    정확한 절차는 다음과 같습니다:
    필요한 정보의 결정(ㄱ) $\rightarrow$ 자료수집방법 결정(ㄴ) $\rightarrow$ 질문형태 결정(ㄹ) $\rightarrow$ 개별항목 결정(ㄷ) $\rightarrow$ 질문의 순서 결정(ㅁ) $\rightarrow$ 초안완성(ㅂ) $\rightarrow$ 사전조사(ㅅ) $\rightarrow$ 질문지 완성(ㅇ)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

19. 전화조사의 장점과 가장 거리가 먼 것은?

  1. 신속한 조사가 가능하다.
  2. 면접자에 대한 감독이 용이하다.
  3. 표본의 대표성을 확보하기 쉽다.
  4. 광범위한 지역에 대한 조사가 용이하다.
(정답률: 52%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

20. 자료수집방법 중 관찰에 관한 설명으로 틀린 것은?

  1. 복잡한 사회적 맥락이나 상호작용을 연구하는데 적절한 방법이다.
  2. 피조사자가 느끼지 못하는 행위까지 조사할 수 있다.
  3. 양적 연구와 질적 연구에 모두 활용될 수 있다.
  4. 의사소통능력이 없는 대상자에게는 활용될 수 없다.
(정답률: 82%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

21. 자신의 신분을 밝히지 않은 채 집단의 완전한 성원이 되어 자연스럽게 일어나는 사회적 과정에 참여하는 관찰자의 역할은?

  1. 완전참여자(Complete Participant)
  2. 완전관찰자(Complete Observer)
  3. 참여자로서의 관찰자(Observer as Participant)
  4. 관찰자로서의 참여자(Participant as Observer)
(정답률: 81%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

22. 대인 면접조사의 특성으로 옳은 것은?

  1. 연구문제에 대한 사전지식이 부족할수록 구조화된 대인 면접조사방법을 사용하는 것이 좋다.
  2. 대인 면접조사는 우편 설문조사에 비해 질문과정의 유연성이 상대적으로 높다.
  3. 대인 면접조사는 우편 설문조사에 비해 환경 차이에 의한 설문응답의 무작위적 오류를 증가시킨다.
  4. 대인 면접조사는 우편 설문조사에 비해 응답률이 낮다.
(정답률: 79%)
  • 대인 면접조사는 면접자가 응답자와 직접 대면하여 진행하므로, 응답자의 반응에 따라 질문의 순서를 조정하거나 추가 설명을 제공하는 등 우편 설문조사에 비해 질문 과정의 유연성이 상대적으로 높습니다.

    오답 노트

    사전지식이 부족할 때: 비구조화 면접이 유리함
    환경 차이 오류: 우편 조사가 더 큼
    응답률: 우편 조사보다 대인 면접이 훨씬 높음
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

23. 단일사례연구에 관한 설명으로 틀린 것은?

  1. 외적 타당도가 높다.
  2. 개입효과에 대한 즉각적인 피드백이 가능하다.
  3. 조사연구 과정과 실천과정이 통합될 수 있다.
  4. 개인과 집단뿐만 아니라 조직이나 지역사회도 연구대상이 될 수 있다.
(정답률: 65%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

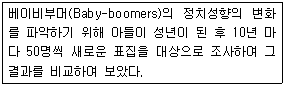
24. 다음의 조사유형으로 옳은 것은?

  1. 횡단(Cross-sectional)조사
  2. 추세(Trend)조사
  3. 코호트(Cohort)조사
  4. 패널(Panel)조사
(정답률: 66%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

25. 집중면접(Focused Interview)에 관한 설명으로 가장 적합한 것은?

  1. 특정한 가설에 개발하기 위해 효율적으로 이용할 수 있다.
  2. 면접자의 통제 하에 제한된 주제에 대해 토론한다.
  3. 개인의 의견보다는 주로 집단적 경험을 이야기 한다.
  4. 사전에 준비한 구조화된 질문지를 이용하여 면접한다.
(정답률: 34%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

26. 다음 중 작업가설(Working Hypothesis)로 적합하지 않은 것은?

  1. 교육수준이 높을수록 소득이 높을 것이다.
  2. 21세기 후반에 이르면 서구문명은 몰락하게 될 것이다.
  3. 계층 간 소득격차가 클수록 사회갈등이 심화 될 것이다.
  4. 출산율은 도시보다 농촌이 더 높을 것이다.
(정답률: 76%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

27. 2차 자료의 이용에 관한 설명으로 틀린 것은?

  1. 2차 자료의 이점은 시간과 비용을 절약할 수 있다.
  2. 2차 자료는 조사목적의 적합성, 자료의 정확성, 일치성 등을 기준으로 평가될 수 있다.
  3. 조사목적을 달성하기 위해서는 2차 자료가 반드시 필요하다.
  4. 2차 자료는 경우에 따라 당면한 조사문제를 평가할 수도 있다.
(정답률: 86%)
  • 2차 자료는 이미 수집된 자료를 활용하므로 시간과 비용을 절약할 수 있고, 조사 목적의 적합성이나 정확성을 평가하여 활용할 수 있는 유용한 수단입니다. 하지만 연구 목적에 따라 1차 자료만으로도 충분히 조사가 가능하므로, 2차 자료가 반드시 필요한 것은 아닙니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

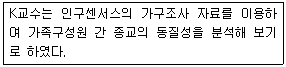
28. 다음 사례의 분석단위로 가장 적합한 것은?

  1. 가구원
  2. 가구
  3. 종교
  4. 국가
(정답률: 66%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

29. 순수실험설계에 관한 설명으로 옳은 것은?

  1. 통제집단 사전사후설계의 경우 주시험효과를 제거하기 어렵다.
  2. 순수실험설계는 학문적 연구보다 상업적 연구에서 주로 활용된다.
  3. 통제집단 사후실험설계는 결과변수 값을 두 번 측정한다.
  4. 솔로몬 4개 집단설계는 통제집단 사전사후설계와 통제집단 사후실험설계의 결합 형태이다.
(정답률: 74%)
  • 솔로몬 4개 집단설계는 사전측정으로 인한 시험효과를 통제하기 위해 통제집단 사전사후설계와 통제집단 사후실험설계를 결합한 가장 정교한 실험설계 방식입니다.

    오답 노트

    통제집단 사전사후설계: 주시험효과가 아니라 독립변수와 사전측정이 상호작용하는 상호작용 시험효과가 발생할 가능성이 큼
    순수실험설계: 상업적 연구보다 엄격한 통제가 필요한 학문적 연구에서 주로 활용됨
    통제집단 사후실험설계: 사전측정 없이 사후에 한 번만 측정함
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

30. 질문지를 작성할 때 고려하여야 할 사항과 가장 거리가 먼 것은?

  1. 관련 있는 질문의 경우 한 문항으로 묶어서 문항수를 줄인다.
  2. 특정한 대답을 암시하거나 유도해서는 안 된다.
  3. 모호한 질문을 피한다.
  4. 응답자의 수준에 맞는 언어를 사용한다.
(정답률: 86%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

2과목: 조사방법론 II

31. 다음 설명에 포함되어 있는 타당도 저해 요인은?
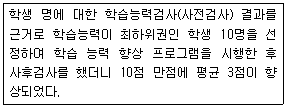
  1. 역사적 요인
  2. 실험대상의 변동
  3. 통계적 회귀
  4. 선정요인
(정답률: 70%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

32. 측정과정에서 신뢰성을 높이기 위한 방법에 관한 설명으로 틀린 것은?

  1. 응답자에 따라 다양한 면접방식을 적용한다.
  2. 측정항목의 모호성을 제거한다.
  3. 측정항목의 수를 늘린다.
  4. 응답자가 모르는 내용은 측정하지 않는다.
(정답률: 70%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

33. 다음 중 불법 체류자처럼 일반적으로 쉽게 접근하기 힘든 집단을 대상으로 설문조사를 할 때 가장 적합한 표본추출방법은?

  1. 눈덩이표본추출(Snowball Sampling)
  2. 편의표본추출(Convenience Sampling)
  3. 판단표본추출(Judgment Sampling)
  4. 할당표본추출(Quota Sampling)
(정답률: 84%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

34. 표본의 크기에 관한 설명으로 틀린 것은?

  1. 허용오차가 클수록 표본의 크기가 커야 한다.
  2. 조사하고자 하는 변수의 분산값이 클수록 표본의 크기는 커야 한다.
  3. 추정치에 대한 높은 신뢰수준이 요구될수록 표본의 크기는 커야 한다.
  4. 비확률 표본추출의 경우 표본의 크기는 예산과 시간을 고려하여 조사자가 결정할 수 있다.
(정답률: 57%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

35. 질적 변수와 양적 변수에 관한 설명으로 틀린 것은?

  1. 질적 변수는 속성의 값을 나타내는 수치의 크기가 의미 없는 변수이다.
  2. 양적 변수는 측정한 속성값을 연산이 가능한 의미 있는 수치로 나타낼 수 있다.
  3. 양적 변수는 이산변수와 연속변수로 구분된다.
  4. 몸무게가 80kg 이상인 사람을 1로, 이하인 사람을 0으로 표시하는 것은 질적 변수를 양적 변수로 변화시킨 것이다.
(정답률: 67%)
  • 몸무게라는 양적 변수를 80kg 기준으로 0과 1로 구분하여 표시하는 것은 양적 변수를 질적 변수(더미 변수)로 변환한 것입니다.

    오답 노트

    몸무게가 80kg 이상인 사람을 1로, 이하인 사람을 0으로 표시하는 것은 질적 변수를 양적 변수로 변화시킨 것이다: 양적 변수를 질적 변수로 변화시킨 사례입니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

36. 사회조사에서 개념의 재정의(Reconceptualization)가 필요한 이유와 가장 거리가 먼 것은?

  1. 사회조사에서 사용되는 개념은 일상생활에서 통상적으로 사용되는 상투어와는 그 의미가 다를 수 있기 때문이다.
  2. 동일한 개념이라도 사회가 변함에 따라 원래의 뜻이 변할 수 있기 때문이다.
  3. 한 가지 개념이라도 두 가지 또는 그 이상의 다양한 의미를 가지고 있을 가능성이 많으므로 이들 각기 다른 의미 중에서 어떤 특정의 의미를 조사연구 대상으로 삼을 것인가를 밝혀야 하기 때문이다.
  4. 개념과 개념 간의 상관관계가 아닌 인과관계를 밝혀야 하기 때문이다.
(정답률: 82%)
  • 개념의 재정의는 일상적 상투어와의 차이, 사회 변화에 따른 의미 변동, 다의적 의미 중 특정 의미 확정 등을 위해 필요합니다. 반면, 상관관계나 인과관계를 밝히는 것은 개념 정의 이후의 분석 단계인 가설 설정 및 검증 과정에 해당하므로 재정의의 직접적인 이유가 아닙니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

37. 크론바흐 알파계수(Cronbach's alpha)에 관한 설명으로 틀린 것은?

  1. 척도를 구성하는 항목들 간에 나타난 상관관계 값을 평균처리한 것이다.
  2. 크론바흐 알파계수는 –1에서 +1의 값을 취한다.
  3. 척도를 구성하는 항목 중 신뢰도를 저해하는 항목을 발견해 낼 수 있다.
  4. 척도를 구성하는 항목간의 내적 일관성을 측정한다.
(정답률: 69%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

38. 특정 지역 전체인구의 1/4은 A구역에, 3/4은 B구역에 분포되어 있고, A, B 두 구역의 인구 중 60%가 고졸자이고 40%가 대졸자라고 가정한다. 이들 A, B 두 구역의 할당표본표집의 크기를 1,000명으로 제한한다면, A지역의 고졸자와 대졸자는 각각 몇 명씩 조사해야 하는가?

  1. 고졸자 100명, 대졸자 150명
  2. 고졸자 150명, 대졸자 100명
  3. 고졸자 450명, 대졸자 300명
  4. 고졸자 300명, 대졸자 450명
(정답률: 78%)
  • 전체 표본 크기에서 구역별 인구 비율을 먼저 구한 뒤, 해당 구역 내의 학력별 비율을 곱하여 산출합니다.
    ① [기본 공식]
    $$A_{high} = Total \times Ratio_{A} \times Ratio_{high}$$
    $$A_{univ} = Total \times Ratio_{A} \times Ratio_{univ}$$
    ② [숫자 대입]
    $$A_{high} = 1000 \times \frac{1}{4} \times 0.6$$
    $$A_{univ} = 1000 \times \frac{1}{4} \times 0.4$$
    ③ [최종 결과]
    $$A_{high} = 150$$
    $$A_{univ} = 100$$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

39. 다음 설명에 해당하는 척도는?

  1. 크루스칼(Kruskal) 척도
  2. 서스톤(Thurstone) 척도
  3. 보가더스(Borgadus) 척도
  4. 거트만(Guttman) 척도
(정답률: 62%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

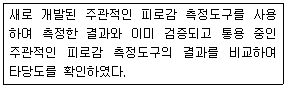
40. 다음 사례에 해당하는 타당성은?

  1. 내용타당성(Content Validity)
  2. 동시타당성(Concurrent Validity)
  3. 예측타당성(Predictive Validity)
  4. 판별타당성(Discriminant Validity)
(정답률: 47%)
  • 이미지 의 사례처럼 새로운 측정 도구의 결과와 이미 검증된 기존 도구의 결과를 동일한 시점에서 비교하여 타당도를 확인하는 것은 동시타당성에 해당합니다.

    오답 노트

    내용타당성: 측정 도구가 측정하려는 내용을 얼마나 대표하는가에 집중함
    예측타당성: 현재의 측정값으로 미래의 결과를 예측하는 정도를 평가함
    판별타당성: 서로 다른 개념을 측정했을 때 상관관계가 없는지를 확인함
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

41. 사회과학에서 척도를 구성하는 이유와 가장 거리가 먼 것은?

  1. 측정의 신뢰성을 높여준다.
  2. 변수에 대한 질적인 측정치를 제공한다.
  3. 하나의 지표로 측정하기 어려운 복합적인 개념들을 측정한다.
  4. 여러 개의 지표를 하나의 점수로 나타내어 자료의 복잡성을 덜어준다.
(정답률: 67%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

42. “상경계열에 다니는 대학생이 이공계열에 다니는 대학생보다 물가변동에 대한 관심이 더 높을 것이다.”라는 가설에서 '상경계열학생 유무'라는 변수를 척도로 나타낼 때 이 척도의 성격은?

  1. 순위척도
  2. 명목척도
  3. 서열척도
  4. 비율척도
(정답률: 79%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

43. 체계적 표집에서 집단의 크기가 100만 명이고 표본의 크기가 1,000명일 때, 다음 중 가장 적합한 표집방법은?

  1. 먼저 단순무작위로 1,000명을 뽑아 그 중에서 편중된 표본은 제거하고, 그것을 대체하는 표본을 다시 뽑는다.
  2. 최초의 사람을 무작위로 선정한 후 매 번째 사람을 고른다.
  3. 모집단이 너무 크기 때문에 100만 명을 1,000개의 집단으로 나누어야 한다.
  4. 모집단을 1,000개의 하위집단으로 나누고, 그 하위집단에서 1명씩 고르면 된다.
(정답률: 65%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

44. 측정의 오류에 관한 설명으로 옳은 것은?

  1. 편향에 의해 체계적 오류가 발생한다.
  2. 무작위 오류는 측정의 타당도를 저해한다.
  3. 표준화된 측정도구를 사용하더라도 체계적 오류를 줄일 수 없다.
  4. 측정자, 측정 대상자 등에 일관성이 없어 생기는 오류를 체계적 오류라 한다.
(정답률: 55%)
  • 특정한 방향으로 치우친 편향(Bias)이 발생하면 일정한 패턴을 가진 체계적 오류가 나타나게 됩니다.

    오답 노트

    무작위 오류: 타당도가 아닌 신뢰도를 저해함
    표준화된 도구: 사용 시 체계적 오류를 줄일 수 있음
    일관성 없는 오류: 체계적 오류가 아닌 비체계적(무작위) 오류임
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

45. 일반적인 표본추출과정을 바르게 나열한 것은?

  1. 표본크기 결정→모집단 확정→표본틀 결정→표본추출방법 결정→표본추출
  2. 모집단 확정→표본크기 결정→표본틀 결정→표본추출방법 결정→표본추출
  3. 모집단 확정→표본틀 결정→표본추출방법 결정→표본크기 결정→표본추출
  4. 표본틀 결정→모집단 확정→표본크기 결정→표본추출방법 결정→표본추출
(정답률: 71%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

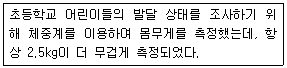
46. 다음 사례의 측정에 대한 설명으로 옳은 것은?

  1. 타당도는 높지만 신뢰도는 낮다.
  2. 신뢰도는 높지만 타당도는 낮다.
  3. 신뢰도도 높고 타당도도 높다.
  4. 신뢰도도 낮고 타당도도 낮다.
(정답률: 75%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

47. 개념적 정의와 조작적 정의에 관한 설명으로 틀린 것은?

  1. 개념적 정의는 추상적 수준의 정의이다.
  2. 조작적 정의는 인위적이기 때문에 가급적 피해야 한다.
  3. 개념적 정의와 조작적 정의가 반드시 일치하는 것은 아니다.
  4. 조작적 정의는 측정을 위하여 불가피하다.
(정답률: 80%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

48. 개념타당성(Construct Validity)의 종류가 아닌 것은?

  1. 이해타당성(Nomological Validity)
  2. 집중타당성(Convergent Validity)
  3. 판별타당성(Discriminant Validity)
  4. 기준 관련 타당성(Criterion-related Validity)
(정답률: 59%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

49. 전수조사와 비교한 표본조사의 특징에 관한 설명으로 옳은 것은?

  1. 시간과 노력이 많이 든다.
  2. 비표본오차를 줄일 수 있다.
  3. 항상 정확한 자료를 수집할 수 있다.
  4. 조사기간 동안에 발생하는 변화를 반영하지 못한다.
(정답률: 65%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

50. 측정의 신뢰성(Reliability)과 가장 거리가 먼 개념은?

  1. 유연성(Flexibility)
  2. 안정성(Stability)
  3. 일관성(Consistency)
  4. 예측가능성(Predictability)
(정답률: 68%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

51. 모든 요소의 총체로서 조사자가 표본을 통해 발견한 사실을 토대로 하여 일반화하고자 하는 궁극적인 대상을 지칭하는 것은?

  1. 표본추출단위(Sampling Unit)
  2. 표본추출분포(Sampling Distribution)
  3. 표본추출 프레임(Sampling Frame)
  4. 모집단(Population)
(정답률: 74%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

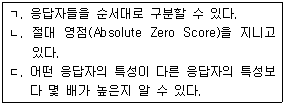
52. 서열측정의 특징을 모두 고른 것은?

  1. ㄱ
  2. ㄱ, ㄴ
  3. ㄴ, ㄷ
  4. ㄱ, ㄴ, ㄷ
(정답률: 76%)
  • 서열측정은 특정 기준에 따라 대상의 순위를 매기는 척도이므로 응답자들을 순서대로 구분할 수 있는 것이 핵심 특징입니다.

    오답 노트

    절대 영점을 지니고 있다: 비율척도의 특징입니다.
    어떤 응답자의 특성이 다른 응답자의 특성보다 몇 배가 높은지 알 수 있다: 비율척도에서만 가능하며, 서열척도는 간격이 일정하지 않아 배수 계산이 불가능합니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

53. 다음 설명에 해당하는 척도는?

  1. 의미분화 척도(Semantic Differential Scale)
  2. 서스톤 척도(Thruston Scale)
  3. 스타펠 척도(Staple Scale)
  4. 거트만 척도(Guttman Scale)
(정답률: 79%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

54. 전문직에 종사하는 남성근로자를 대상으로 하는 사회조사에서 변수가 될 수 없는 것은?

  1. 연령
  2. 성별
  3. 직업종류
  4. 근무시간
(정답률: 80%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

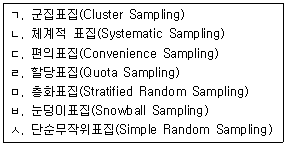
55. 확률 표본추출 방법만으로 짝지어진 것은?

  1. ㄱ, ㄴ, ㄷ, ㄹ
  2. ㄱ, ㄹ, ㅁ, ㅂ
  3. ㄴ, ㄹ, ㅂ, ㅅ
  4. ㄱ, ㄴ, ㅁ, ㅅ
(정답률: 79%)
  • 확률 표본추출은 모집단의 모든 요소가 표본으로 선택될 확률이 동일하거나 알려져 있는 객관적인 방법입니다.
    확률 표본추출에 해당하는 항목은 다음과 같습니다.
    ㄱ. 군집표집(Cluster Sampling)
    ㄴ. 체계적 표집(Systematic Sampling)
    ㅁ. 층화표집(Stratified Random Sampling)
    ㅅ. 단순무작위표집(Simple Random Sampling)

    오답 노트

    ㄷ. 편의표집, ㄹ. 할당표집, ㅂ. 눈덩이표집: 조사자의 주관이 개입되는 비확률 표본추출 방법입니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

56. 층화표집과 집락표집에 관한 설명으로 옳은 것은?

  1. 층화표집은 모든 부분집단에서 표본을 선정한다.
  2. 집락표집은 모집단을 하나의 집단으로만 분류한다.
  3. 집락표집은 부분집단 내에 동질적인 요소로 이루어진다고 전제한다.
  4. 층화표집은 부분집단 간에 동질적인 요소로 이루어진다고 전제한다.
(정답률: 62%)
  • 층화표집은 모집단을 서로 겹치지 않는 동질적인 부분집단(층)으로 나눈 후, 모든 부분집단에서 무작위로 표본을 추출하는 방법입니다.

    오답 노트

    집락표집은 모집단을 하나의 집단으로만 분류하는 것이 아니라 여러 개의 집락으로 분류합니다.
    집락표집: 집락 내부는 이질적, 집락 간에는 동질적이어야 합니다.
    층화표집: 부분집단 내부는 동질적, 부분집단 간에는 이질적이어야 합니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

57. 척도구성 방법을 비교 척도구성(Comparative Scaling)과 비비교 척도구성(Noncomparative Scaling)으로 구분할 때 비비교 척도구성에 해당하는 것은?

  1. 쌍대 비교법(Paired Comparison)
  2. 순위법(Rank-order)
  3. 연속 평정법(Continuous Rating)
  4. 고정 총합법(Constant Sum)
(정답률: 60%)
  • 비비교 척도구성은 다른 대상과 비교하지 않고 개별 대상의 특성을 독립적으로 측정하는 방식입니다. 연속 평정법은 평정 척도의 일종으로, 특정 대상에 대해 독립적으로 점수를 부여하므로 비비교 척도구성에 해당합니다.

    오답 노트

    쌍대 비교법, 순위법, 고정 총합법: 대상 간의 상대적 비교를 통해 측정하는 비교 척도구성 방식입니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

58. 응답자의 월평균 소득금액을 '원' 단위로 조사하고자 하는 경우에 적합한 척도는?

  1. 비율척도
  2. 등간척도
  3. 서열척도
  4. 명목척도
(정답률: 75%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

59. 다음 중 사회조사에서 비확률 표본추출이 많이 사용되는 이유로 가장 적합한 것은?

  1. 표본추출오차가 적게 나타난다.
  2. 모집단에 대한 추정이 용이하다.
  3. 표본설계가 용이하고 시간과 비용을 절약할 수 있다.
  4. 모집단 본래의 특성과 차이가 나지 않는 결과를 얻을 수 있다.
(정답률: 69%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

60. 표본오차(Sampling Error)에 관한 설명으로 옳은 것은?

  1. 표본의 크기가 커지면 늘어난다.
  2. 모집단의 표본의 차이에 의해 발생하는 오류를 말한다.
  3. 조사연구의 모든 과정에서 확산되어 발생한다.
  4. 조사원의 훈련부족으로 인해 각기 다른 성격의 자료가 수집되는 경우에 발생한다.
(정답률: 68%)
  • 표본오차는 모집단 전체를 조사하지 않고 일부인 표본만을 추출하여 조사하기 때문에 발생하는 모집단과 표본 간의 차이를 의미합니다.

    오답 노트

    표본의 크기가 커지면: 줄어듭니다.
    조사 과정 전반의 오류: 비표본오차에 해당합니다.
    조사원 훈련 부족: 비표본오차에 해당합니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

3과목: 사회통계

61. 자료의 위치를 나타내는 척도로 알맞지 않은 것은?

  1. 중앙값
  2. 백분위수
  3. 표준편차
  4. 사분위수
(정답률: 67%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

62. 어떤 사회정책에 대한 찬성률을 추정하고자 한다. 크기 n인 임의표본(확률표본)을 추출하여 자료를 x1,⋯,xn 으로 입력하였을 때 에 대한 점 추정치로 옳은 것은? (단, 찬성이면 0, 반대면 1로 코딩한다.)

(정답률: 29%)
  • 찬성률을 구하기 위해서는 전체 표본 수 $n$ 중 찬성자의 수를 세어 나누어야 합니다. 문제에서 찬성을 $0$, 반대를 $1$로 코딩했으므로, 찬성자의 수는 전체 수 $n$에서 반대자의 수인 $\sum x_i$를 뺀 값, 즉 $\sum (1-x_i)$가 됩니다.
    따라서 찬성률의 점 추정치는 가 됩니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

63. 다음 중 표준편차가 가장 큰 자료는?

  1. 3 4 5 6 7
  2. 3 3 5 7 7
  3. 3 5 5 5 7
  4. 5 6 7 8 9
(정답률: 67%)
  • 표준편차는 데이터가 평균으로부터 얼마나 멀리 떨어져 있는지를 나타내는 산포도입니다. 모든 자료의 평균이 $5$로 동일할 때, 데이터가 평균에서 멀리 떨어져 있을수록 표준편차가 큽니다.
    3 3 5 7 7의 경우, 평균 $5$에서 가장 멀리 떨어진 값들이 가장 많으므로 산포도가 가장 커서 표준편차가 최대가 됩니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

64. 어느 공장에서 일주일 동안 생산되는 제품의 수 는 평균이 50, 분산이 15인 확률분포를 따른다. 이 공장의 일주일 동안의 생산량이 45개에서 55개 사이일 확률의 하한을 구하면?

  1. 1/5
  2. 2/5
  3. 3/5
  4. 4/5
(정답률: 28%)
  • 분포의 형태를 모를 때 확률의 하한을 구하는 체비셰프 부등식을 이용합니다.
    ① [기본 공식] $P(|X-\mu| \le k\sigma) \ge 1-\frac{1}{k^2}$
    ② [숫자 대입] 평균 $\mu=50$, 표준편차 $\sigma=\sqrt{15}$이며, 범위가 $45 \le X \le 55$이므로 $k\sqrt{15}=5$에서 $k=\frac{5}{\sqrt{15}}$입니다. 이를 대입하면 $$1-\frac{1}{(\frac{5}{\sqrt{15}})^2} = 1-\frac{15}{25}$$
    ③ [최종 결과] $P = \frac{2}{5}$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

65. 아파트의 평수 및 가족수가 난방비에 미치는 영향을 알아보기 위해 중회귀분석을 실시하여 다음의 결과를 얻었다. 분석 결과에 대한 설명으로 틀린 것은? (단, Y는 아파트 난방비(천원)이다.)
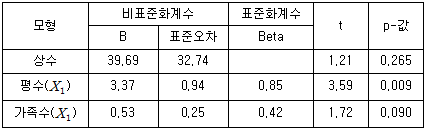
  1. 추정된 회귀식은 이다.
  2. 유의수준 5%에서 종속변수 난방비에 유의한 영향을 주는 독립변수는 평수이다.
  3. 가족수가 주어질 때, 난방비는 아파트가 1평 커질 때 평균 3.37(천원) 증가한다.
  4. 아파트 평수가 30평이고 가족이 5명인 가구의 난방비는 122.44(천원)으로 예측된다.
(정답률: 49%)
  • 제시된 회귀계수 표를 바탕으로 예측값을 계산합니다. 상수항은 $39.69$, 평수($X_{1}$)의 계수는 $3.37$, 가족수($X_{2}$)의 계수는 $0.53$입니다.
    ① [기본 공식] $Y = \beta_{0} + \beta_{1}X_{1} + \beta_{2}X_{2}$
    ② [숫자 대입] $Y = 39.69 + (3.37 \times 30) + (0.53 \times 5)$
    ③ [최종 결과] $Y = 143.44$
    따라서 예측값이 122.44(천원)라는 설명은 틀렸습니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

66. 확률변수 X의 평균은 10, 분산은 5이다. Y=5+2X의 평균과 분산은?

  1. 20, 15
  2. 20, 20
  3. 25, 15
  4. 25, 20
(정답률: 60%)
  • 확률변수의 선형 결합에 따른 평균과 분산의 성질을 이용합니다. 평균은 상수가 그대로 더해지고, 분산은 상수의 제곱이 곱해집니다.
    ① [기본 공식] $E(aX+b) = aE(X)+b, V(aX+b) = a^{2}V(X)$
    ② [숫자 대입] $E(2X+5) = 2 \times 10 + 5, V(2X+5) = 2^{2} \times 5$
    ③ [최종 결과] $E = 25, V = 20$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

67. 정규분포를 따르는 모집단으로부터 10개의 표본을 임의추출한 모평균에 대한 95% 신뢰구간은 (74.76, 165.24)이다. 이때 모평균의 추정치와 추정량의 표준오차는? (단, t가 자유도가 9인 t-분포를 따르는 확률변수일 때, P(t>2.262)=0.025 이다.)

  1. 90.48, 20
  2. 90.48, 40
  3. 120, 20
  4. 120, 40
(정답률: 38%)
  • 신뢰구간의 중심은 모평균의 추정치(표본평균)가 되며, 구간의 너비는 오차 한계의 2배가 됩니다.
    먼저 표준오차를 구합니다.
    ① [기본 공식] $SE = \frac{Upper - Lower}{2 \times t}$
    ② [숫자 대입] $SE = \frac{165.24 - 74.76}{2 \times 2.262}$
    ③ [최종 결과] $SE = 20$
    다음으로 모평균의 추정치를 구합니다.
    ① [기본 공식] $\bar{x} = \frac{Upper + Lower}{2}$
    ② [숫자 대입]- $\bar{x} = \frac{165.24 + 74.76}{2}$
    ③ [최종 결과]- $\bar{x} = 120$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

68. 어느 회사는 노조와 협의하여 오후의 중간 휴식시간을 20분으로 정하였다. 그런데 총무과장은 대부분의 종업원이 규정된 휴식시간보다 더 많은 시간을 쉬고 있다고 생각하고 있다. 이를 확인하기 위하여 전체 종업원 1,000명 중에서 25명을 조사한 결과 표본으로 추출된 종업원의 평균 휴식시간은 22분이고 표준편차는 3분으로 계산되었다. 유의수준 5%에서 총무과장의 의견에 대한 가설검정 결과로 옳은 것은? (단, t(0.05t 24)=1.711)

  1. 검정통계량 t<1.711 이므로 귀무가설을 기각한다.
  2. 검정통계량 t<1.711 이므로 귀무가설을 채택한다.
  3. 종업원의 실제 휴식시간은 규정시간 20분보다 더 길다고 할 수 있다.
  4. 종업원의 실제 휴식시간은 규정시간 20분보다 더 짧다고 할 수 있다.
(정답률: 52%)
  • 표본의 평균이 규정 시간보다 큰지 확인하는 단측 검정 문제입니다. 검정통계량 $t$ 값이 임계값보다 크면 귀무가설을 기각하고 대립가설을 채택합니다.
    ① [기본 공식] $t = \frac{\bar{x} - \mu}{s / \sqrt{n}}$
    ② [숫자 대입] $t = \frac{22 - 20}{3 / \sqrt{25}} = \frac{2}{0.6} = 3.33$
    ③ [최종 결과] $t = 3.33$
    계산된 $t$ 값($3.33$)이 임계값($1.711$)보다 크므로 귀무가설을 기각합니다. 따라서 종업원의 실제 휴식시간은 규정시간 20분보다 더 길다고 할 수 있습니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

69. 회귀분석 결과, 분산분석표에서 잔차제곱합(SSE)은 60, 총제곱합(SST)은 240임을 알았다. 이 회귀모형의 결정계수는?

  1. 0.25
  2. 0.5
  3. 0.75
  4. 0.95
(정답률: 57%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

70. 다음 중 대푯값에 해당하지 않는 것은?

  1. 최빈값
  2. 기하평균
  3. 조화평균
  4. 분산
(정답률: 72%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

71. 343명의 대학생을 랜덤하게 뽑아서 조사한 결과 110명의 학생이 흡연 경험이 있었다. 대학생 중 흡연 경험자 비율에 대한 95% 신뢰구간을 구한 것으로 옳은 것은?(단, z0.025=1.96, z0.05=1.645, z0.1=1.282)

  1. 0.256<p<0.386
  2. 0.279<p<0.362
  3. 0.271<p<0.370
  4. 0.262<p<0.379
(정답률: 47%)
  • 표본 비율을 이용하여 모비율 $p$에 대한 신뢰구간을 구하는 문제입니다.
    표본 비율 $\hat{p} = \frac{110}{343} \approx 0.32$
    ① [기본 공식] $\hat{p} \pm z_{\alpha/2} \sqrt{\frac{\hat{p}(1-\hat{p})}{n}}$
    ② [숫자 대입] $0.32 \pm 1.96 \sqrt{\frac{0.32 \times 0.68}{343}}$
    ③ [최종 결과] $0.32 \pm 0.05 \rightarrow 0.271 < p < 0.370$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

72. 어느 제약회사에서 생산하고 있는 진통제는 복용 후 진통효과가 나타날 때까지 걸리는 시간이 평균 30분, 표준편차 8분인 정규분포를 따른다고 한다. 임의로 추출한 100명의 환자에게 진통제를 복용시킬 때, 복용 후 40분에서 44분 사이에 진통효과가 나타나는 환자의 수는? (단, 다음 표준정규분포표를 이용하시오.)
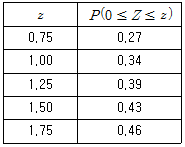
  1. 4
  2. 5
  3. 7
  4. 10
(정답률: 55%)
  • 정규분포를 표준정규분포 $Z$로 변환하여 해당 구간의 확률을 구한 뒤, 전체 인원수를 곱해 환자 수를 산출합니다.
    ① [기본 공식] $Z = \frac{X - \mu}{\sigma}$
    ② [숫자 대입] $P(\frac{40-30}{8} < Z < \frac{44-30}{8}) = P(1.25 < Z < 1.75)$
    ③ [최종 결과] $0.46 - 0.39 = 0.07$
    최종 환자 수: $100 \times 0.07 = 7$명
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

73. 일정기간 공사장지대에서 방목한 가축 소변의 불소 농도에 변화가 있는가를 조사하고자 한다. 랜덤하게 추출한 10마리의 가축 소변의 불소 농도를 방목 초기에 조사하고 일정기간 방목한 후 다시 소변의 불소 농도를 조사하였다. 방목 전후의 불소 농도에 차이가 있는가에 대한 분석방법으로 적합한 것은?

  1. 단일 모평균에 대한 검정
  2. 독립표본에 의한 두 모평균의 비교
  3. 쌍체비교(대응비교)
  4. F-Test
(정답률: 52%)
  • 동일한 대상(가축 10마리)에 대해 방목 전과 후라는 두 시점에서 반복 측정하여 그 차이를 분석하는 경우이므로, 표본 간의 의존성이 존재하는 쌍체비교(대응비교)가 가장 적합합니다.

    오답 노트

    독립표본에 의한 두 모평균의 비교: 서로 다른 두 집단을 비교할 때 사용함
    F-Test: 분산의 동일성을 검정하거나 세 집단 이상의 평균을 비교할 때 사용함
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

74. 확률변수 X는 포아송분포를 따른다고 하자. X의 평균이 5라고 할 때 분산은 얼마인가?

  1. 1
  2. 3
  3. 5
  4. 9
(정답률: 71%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

75. 단순회귀분석을 수행한 결과, 보기와 같은 결과를 얻었다. 결정계수 R2값과 기울기에 대한 가설 H0:β1 에 대한 유의수준 5%에 대한 검정결과로 옳은 것은?(단, )
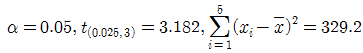
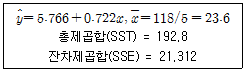
  1. R2=0.889, 기울기를 0이라 할 수 없다.
  2. R2=0.551, 기울기를 0이라 할 수 없다.
  3. R2=0.889, 기울기를 0이라 할 수 있다.
  4. R2=0.551, 기울기를 0이라 할 수 있다.
(정답률: 45%)
  • 결정계수 $R^{2}$는 전체 변동 중 회귀 모델이 설명하는 비율이며, 기울기 $\beta_{1}$의 유의성은 $t$-검정을 통해 판단합니다.
    결정계수 계산:
    ① [기본 공식] $R^{2} = 1 - \frac{SSE}{SST}$
    ② [숫자 대입] $R^{2} = 1 - \frac{21.312}{192.8}$
    ③ [최종 결과] $R^{2} = 0.889$
    기울기 검정:
    잔차분산 $MSE = \frac{SSE}{n-2} = \frac{21.312}{5-2} = 7.104$이고, $S_{xx} = 329.2$ 입니다.
    ① [기본 공식] $t = \frac{\beta_{1}}{\sqrt{MSE / S_{xx}}}$
    ② [숫자 대입] $t = \frac{0.722}{\sqrt{7.104 / 329.2}}$
    ③ [최종 결과] $t = 4.91$
    계산된 $t$값 $4.91$이 임계값 $t_{(0.025, 3)} = 3.182$보다 크므로 귀무가설을 기각합니다. 따라서 기울기를 0이라 할 수 없습니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

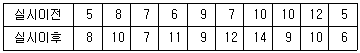
76. 어느 자동차 회사의 영업 담당자는 영업전략의 효과를 검정하고자 한다. 영업사원 10명을 무작위로 추출하여 새로운 영업전략을 실시하기 전과 실시한 후의 영업성과(월 판매량)를 조사하였다. 영업사원의 자동차 판매량의 차이는 정규분포를 따른다고 하자. 유의수준 5%에서 새로운 영업전략이 효과가 있는지 검정한 결과는? (단, 유의수준 5%에 해당하는 자유도 9인 t분포값은 -1.833 이다.)
  1. 새로운 영업전략의 판매량 증가 효과가 있다고 할 수 있다.
  2. 새로운 영업전략의 판매량 증가 효과가 없다고 할 수 있다.
  3. 새로운 영업전략 실시 전후 판매량은 같다고 할 수 있다.
  4. 주어진 정보만으로는 알 수 없다.
(정답률: 50%)
  • 동일 인물에 대한 전후 비교이므로 대응표본 t-검정을 실시합니다. 데이터의 차이($d = \text{후} - \text{전}$)를 계산하면 $[3, 2, 0, 5, 0, 5, 4, -1, -2, 1]$이며, 평균 $\bar{d} = 1.7$, 표준편차 $s_d \approx 2.46$입니다.
    ① [기본 공식] $t = \frac{\bar{d}}{s_d / \sqrt{n}}$
    ② [숫자 대입] $t = \frac{1.7}{2.46 / \sqrt{10}} \approx 2.17$
    ③ [최종 결과] $t = 2.17$
    계산된 $t$값($2.17$)이 임계값($1.833$)보다 크므로, 유의수준 $5\%$에서 귀무가설을 기각하고 새로운 영업전략의 판매량 증가 효과가 있다고 판단합니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

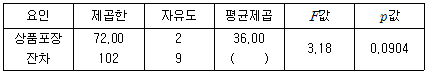
77. 다음 분산분석(ANOVA)표는 상품포장색깔(빨강, 노랑, 파랑)이 판매량에 미치는 영향을 알아보기 위해서 4곳의 가게를 대상으로 실험한 결과이다. 위의 분산분석표에서 ( )에 알맞은 잔차 평균제곱 값은 얼마인가?
  1. 11.33
  2. 14.33
  3. 10.23
  4. 13.23
(정답률: 71%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

78. P(A)=0.4, P(B)=0.2, P(B|A)=0.4일때 P(A|B)는?

  1. 0.4
  2. 0.5
  3. 0.6
  4. 0.8
(정답률: 62%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

79. 다음 중 표본평균()의 분포에 관한 설명으로 틀린 것은?

  1. 표본평균의 분포 평균은 모집단의 평균과 동일하다.
  2. 표본의 크기가 어느 정도 크면 표본평균의 분포는 근사적 정규분포를 따른다.
  3. 표본평균의 분포는 모집단의 분포와 동일하다.
  4. 표본평균의 분포 분산은 표본의 크기에 따라 달라진다.
(정답률: 47%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

80. 왜도가 0이고 첨도가 3인 분포의 형태는?

  1. 좌우 대칭인 분포
  2. 왼쪽으로 치우친 분포
  3. 오른쪽으로 치우친 분포
  4. 오른쪽으로 치우치고 뾰족한 모양의 분포
(정답률: 72%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

81. 표준정규분포를 따르는 확률변수의 제곱은 어떤 분포를 따르는가?

  1. 정규분포
  2. t-분포
  3. F-분포
  4. 카이제곱분포
(정답률: 55%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

82. 다음 설명 중 틀린 것은?

  1. 모수의 추정에 사용되는 통계량을 추정량이라고 하고 추정량의 관측값을 추정치라고 한다.
  2. 모수에 대한 추정량의 기댓값이 모수와 일치할 때 불편추정량이라 한다.
  3. 모표준편차는 표본표준편차의 불편추정량이다.
  4. 표본평균은 모평균의 불편추정량이다.
(정답률: 45%)
  • 불편추정량은 추정량의 기댓값이 실제 모수와 일치하는 것을 의미합니다. 표본분산은 모분산의 불편추정량이지만, 표본표준편차는 모표준편차의 불편추정량이 아닙니다. 즉, 모표준편차를 추정하기 위해 표본표준편차를 사용하지만 기댓값이 일치하지는 않습니다.

    오답 노트

    모표준편차는 표본표준편차의 불편추정량이다: 추정량과 모수의 관계가 반대로 설명되었으며, 표준편차 수준에서는 불편성이 성립하지 않습니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

83. 자료들의 분포형태와 대푯값에 관한 설명으로 옳은 것은?

  1. 오른쪽 꼬리가 긴 분포에서는 중앙값이 평균보다 크다.
  2. 왼쪽 꼬리가 긴 분포에서는 최빈값 < 평균 < 중앙값 순이다.
  3. 중앙값은 분포와 무관하게 최빈값보다 작다.
  4. 비대칭의 정도가 강한 경우에는 대푯값으로 평균보다 중앙값을 사용하는 것이 더 바람직하다고 할 수 있다.
(정답률: 64%)
  • 데이터의 분포가 매우 비대칭이거나 극단적인 이상치가 존재하는 경우, 평균은 이에 민감하게 반응하여 왜곡될 수 있으므로 데이터의 중앙 위치를 나타내는 중앙값을 대푯값으로 사용하는 것이 더 적절합니다.

    오답 노트

    오른쪽 꼬리가 긴 분포: 평균 > 중앙값 > 최빈값 순입니다.
    왼쪽 꼬리가 긴 분포: 최빈값 > 중앙값 > 평균 순입니다.
    중앙값과 최빈값의 관계: 분포의 형태에 따라 상대적 크기가 달라집니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

84. 다음의 자료에 대한 절편이 없는 단순회귀모형 Yi=βxi+εi 를 가정할 때, 최소제곱법에 의한 β의 추정값을 구하면?
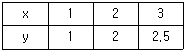
  1. 0.75
  2. 0.82
  3. 0.89
  4. 0.96
(정답률: 30%)
  • 절편이 없는 단순회귀모형에서 회귀계수 $\beta$는 독립변수와 종속변수의 곱의 합을 독립변수의 제곱합으로 나누어 계산합니다.
    ① [기본 공식] $\beta = \frac{\sum x_i y_i}{\sum x_i^2}$
    ② [숫자 대입] $\beta = \frac{1 \times 1 + 2 \times 2 + 3 \times 2.5}{1^2 + 2^2 + 3^2}$
    ③ [최종 결과] $\beta = 0.89$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

85. 어떤 철물점에서 10가지 길이의 못을 팔고 있으며, 못의 길이는 각각 2.5, 3.0, 4.0, 4.5, 5.0, 5.5, 6.0, 6.5, 7.0cm이다. 만약 현재 남아 있는 못 가운데 10%는 4.0cm인 못이고, 15%는 5.0cm인 못이며, 53%는 5.5cm인 못이라면 현재 이 철물점에 있는 못 길이의 최빈수는?

  1. 4.5cm
  2. 5.0cm
  3. 5.5cm
  4. 6.0cm
(정답률: 75%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

86. 똑같은 크기의 사과 10개를 다섯 명의 어린이에게 나누어주는 방법의 수는? (단, 은 n개 중에서 r개를 선택하는 조합의 수이다.)

(정답률: 48%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

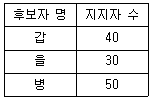
87. 어느 지방선거에서 각 후보자의 지지도를 알아보기 위하여 120명을 표본으로 추출하여 다음과 같은 결과를 얻었다. 세 후보 간의 지지도가 같은지를 검정하기 위한 검정통계량의 값은?
  1. 2
  2. 4
  3. 5
  4. 8
(정답률: 41%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

88. 일원분산분석에 대한 설명으로 틀린 것은?

  1. 제곱합들의 비를 이용하여 분석하므로 F분포를 이용하여 검정한다.
  2. 오차제곱합을 이용하므로 X2분포를 이용하여 검정할 수도 있다.
  3. 세 개 이상 집단 간의 모평균을 비교하고자 할 때 사용한다.
  4. 총제곱합은 처리제곱합과 오차제곱합으로 분해된다.
(정답률: 39%)
  • 일원분산분석(ANOVA)은 세 개 이상의 집단 간 평균 차이를 검정하기 위해 처리제곱합과 오차제곱합의 비율을 이용하며, 이때 검정통계량은 $F$분포를 따릅니다.

    오답 노트

    오차제곱합을 이용하므로 $\chi^{2}$분포를 이용하여 검정할 수도 있다: 분산분석의 최종 검정은 $F$분포를 사용합니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

89. 확률변수 X는 시행횟수가 n이고, 성공할 확률이 p인 이항분포를 따를 때, 옳은 것은?
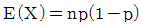
(정답률: 52%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

90. 다음 중 가설검정에 관한 설명으로 옳은 것은?(문제 오류로 가답안 발표시 4번으로 발표되었지만 확정답안 발표시 2, 4번이 정답 처리 되었습니다. 여기서는 가답안인 4번을 누르면 정답 처리 됩니다.)

  1. 일반적으로 표본자료에 의해 입증하고자 하는 가설을 대립가설로 세운다.
  2. 1종 오류와 2종 오류 중 더 심각한 오류는 1종 오류이다.
  3. p-값이 유의수준보다 크면 귀무가설을 기각한다.
  4. 양측검정으로 유의하지 않은 자료라도 단측검정을 하면 유의할 수도 있다.
(정답률: 45%)
  • 양측검정은 양방향 모두를 확인하므로 기각역이 분산되어 유의하지 않을 수 있지만, 단측검정은 한쪽 방향으로 기각역이 집중되므로 동일한 데이터라도 유의미한 결과가 나올 가능성이 높습니다.

    오답 노트

    일반적으로 표본자료에 의해 입증하고자 하는 가설: 대립가설이 아니라 귀무가설을 기각함으로써 입증함
    1종 오류와 2종 오류 중 더 심각한 오류: 문제 맥락에 따라 다르나 일반적으로 1종 오류를 더 엄격하게 관리함 (정답 인정 범위)
    p-값이 유의수준보다 크면: 귀무가설을 기각하지 못함
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

91. 교육수준에 따른 생활만족도의 차이를 다양한 배경변수를 통제한 상태에서 비교하기 위해서 다중회귀분석을 실시하고자 한다. 교육수준을 5개의 범주로(무학, 초졸, 중졸, 고졸, 대졸 이상) 측정하였다. 이때 대졸을 기준으로 할 때, 교육수준별 차이를 나타내는 가변수(Dummy Variable)를 몇 개 만들어야 하는가?

  1. 1개
  2. 2개
  3. 3개
  4. 4개
(정답률: 65%)
  • 범주형 변수를 회귀분석에 사용하기 위해 만드는 가변수의 개수는 전체 범주 수에서 1을 뺀 값($k-1$)과 같습니다. 교육수준이 5개 범주이고 대졸이 기준 집단이므로, 나머지 4개 범주에 대해 가변수를 생성해야 합니다.
    ① [기본 공식]
    $$\text{가변수 개수} = k - 1$$
    ② [숫자 대입]
    $$\text{가변수 개수} = 5 - 1$$
    ③ [최종 결과]
    $$\text{가변수 개수} = 4$$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

92. 사회조사분석사 시험 응시생 500명의 통계학 성적의 평균점수는 70점이고, 표준편차는 10점이라고 한다. 통계학 성적이 정규분포를 따른다고 할 때, 성적이 50점에서 90점 사이인 응시자는 약 몇 명인가? (단, P(Z<2)=0.9772)

  1. 498명
  2. 477명
  3. 378명
  4. 250명
(정답률: 59%)
  • 정규분포를 표준정규분포 $Z$로 변환하여 해당 범위의 확률을 구한 뒤, 전체 인원수를 곱하여 인원수를 산출합니다.
    ① [기본 공식]
    $$Z = \frac{X - \mu}{\sigma}$$
    ② [숫자 대입]
    $$Z_1 = \frac{50 - 70}{10} = -2, \quad Z_2 = \frac{90 - 70}{10} = 2$$
    $$P(-2 < Z < 2) = 0.9772 - (1 - 0.9772) = 0.9544$$
    ③ [최종 결과]
    $$500 \times 0.9544 = 477.2 \approx 477$$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

93. 모집단으로부터 크기가 100인 표본을 추출하였다. 이 표본으로부터 표본비율 를 추정하였다. 모비율에 대한 가설 H0:p=0.4 vs H1:p>0.4를 검정하기 위한 검정통계량은?
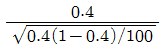
(정답률: 66%)
  • 모비율 검정에서 검정통계량 $Z$는 표본비율과 가설상의 모비율의 차이를 표준오차로 나누어 계산합니다.
    ① [기본 공식]
    $$Z = \frac{\hat{p} - p}{\sqrt{\frac{p(1-p)}{n}}}$$
    ② [숫자 대입]
    $$Z = \frac{0.42 - 0.4}{\sqrt{0.4(1-0.4)/100}}$$
    ③ [최종 결과]
    $$\text{정답: } \frac{0.42 - 0.4}{\sqrt{0.4(1-0.4)/100}}$$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

94. 변수 x와 y에 대한 n개의 n개의 자료 (x1,y1),⋯,(xn,yn) 에 대하여 단순선형회귀모형 y=β0+β1xi+εi을 적합시키는 경우, 잔차 에 대한 성질이 아닌 것은?
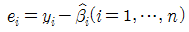
(정답률: 51%)
  • 단순선형회귀모형에서 잔차 $e_i$는 실제값 $y_i$와 예측값 $\hat{y}_i$의 차이로 정의됩니다. 따라서 $\text{}$ 즉, $e_i = y_i - \hat{\beta}_i$라는 표현은 예측값 $\hat{y}_i$가 아닌 회귀계수 $\hat{\beta}_i$를 뺐으므로 잘못된 정의입니다. 올바른 정의는 $e_i = y_i - \hat{y}_i$입니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

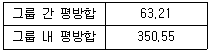
95. 서로 다른 4가지 교수방법 A, B, C, D의 학습 효과를 알아보기 위하여 같은 수준에 있는 학생중에서 99명을 임의추출하여 A교수방법에 19명, B교수방법에 31명, C교수방법에 27명, D교수방법에 22명을 할당하였다. 일정 기간 수업 후 성취도를 100점 만점으로 측정, 정리하여 다음의 평방합(제곱합)을 얻었다. 교수방법 A, B, C, D의 학습효과사이에 차이가 있는가를 검정하기 위한 F-통계량 값은?
  1. 0.175
  2. 0.180
  3. 5.71
  4. 8.11
(정답률: 34%)
  • F-통계량은 집단 간 평균제곱(MSB)을 집단 내 평균제곱(MSW)으로 나눈 값입니다. 평균제곱은 평방합을 해당 자유도로 나누어 계산합니다.
    자유도: 집단 간 $4-1=3$, 집단 내 $99-4=95$
    ① [기본 공식] $F = \frac{SSB / df_B}{SSW / df_W}$
    ② [숫자 대입] $F = \frac{63.21 / 3}{350.55 / 95}$
    ③ [최종 결과] $F = 5.71$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

96. Y의 X에 대한 회귀직선식이 라 한다. Y의 표준편차가 5, X의 표준편차가 3일 때, X와 Y에의 상관계수는?

  1. 0.6
  2. 1
  3. 0.8
  4. 0.5
(정답률: 44%)
  • 상관계수는 회귀계수에 독립변수의 표준편차를 곱하고 이를 종속변수의 표준편차로 나누어 구할 수 있습니다. 주어진 회귀식 $\hat{Y} = 3 + X$에서 회귀계수는 $1$입니다.
    ① [기본 공식] $r = \frac{b \times s_x}{s_y}$
    ② [숫자 대입] $r = \frac{1 \times 3}{5}$
    ③ [최종 결과] $r = 0.6$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

97. 분산분석의 기본 가정이 아닌 것은?

  1. 각 모집단에서 반응변수는 정규분포를 따른다.
  2. 각 모집단에서 독립변수는 F분포를 따른다.
  3. 반응변수의 분산은 모든 모집단에서 동일하다.
  4. 관측값들은 독립적이어야 한다.
(정답률: 41%)
  • 분산분석(ANOVA)의 기본 가정은 반응변수가 정규분포를 따르고, 각 집단의 분산이 동일하며(등분산성), 관측값들이 서로 독립적이어야 한다는 것입니다.

    오답 노트

    각 모집단에서 독립변수는 F분포를 따른다: 독립변수는 분석자가 설정하는 요인이며, F분포는 검정 통계량이 따르는 분포이지 독립변수의 분포가 아닙니다.
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

98. 평균이 μ이고 분산이 16인 정규모집단으로부터 크기가 100인 확률분포의 평균을 라 하자. H0:μ=8 vs H1:μ=6.416의 검정을 위해 기각역을 <7.2로 할 때, 제1종 오류와 제2종 오류를 범할 확률은? (단, P(Z<2)=0.977, P(X<1.96)=0.975, P(Z<1.645)=0.95), P(Z<1)=0.842)

  1. 제1종 오류를 범할 확률 0.05, 제2종 오류를 범할 확률 0.025
  2. 제1종 오류를 범할 확률 0.023, 제2종 오류를 범할 확률 0.025
  3. 제1종 오류를 범할 확률 0.023, 제2종 오류를 범할 확률 0.05
  4. 제1종 오류를 범할 확률 0.05, 제2종 오류를 범할 확률 0.023
(정답률: 35%)
  • 제1종 오류는 귀무가설이 참일 때 이를 기각할 확률이며, 제2종 오류는 대립가설이 참일 때 귀무가설을 채택할 확률입니다. 표본평균 $\bar{X}$의 표준편차는 $\sqrt{16/100} = 0.4$를 사용합니다.
    제1종 오류 확률: $\mu=8$일 때 $\bar{X} < 7.2$일 확률
    ① [기본 공식] $Z = \frac{\bar{X} - \mu}{\sigma / \sqrt{n}}$
    ② [숫자 대입] $Z = \frac{7.2 - 8}{0.4} = -2$
    ③ [최종 결과] $P(Z < -2) = 1 - 0.977 = 0.023$
    제2종 오류 확률: $\mu=6.416$일 때 $\bar{X} \ge 7.2$일 확률
    ① [기본 공식] $Z = \frac{\bar{X} - \mu}{\sigma / \sqrt{n}}$
    ② [숫자 대입] $Z = \frac{7.2 - 6.416}{0.4} = 1.96$
    ③ [최종 결과] $P(Z \ge 1.96) = 1 - 0.975 = 0.025$
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

99. Y=a+bX, (b>0)인 관계가 성립할 때 두 확률변수 X와 Y 간의 상관계수 ρX,Y 는?

  1. ρX,Y=1.0
  2. ρX,Y=0.8
  3. ρX,Y=0.6
  4. ρX,Y=0.4
(정답률: 56%)
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

100. 결혼시기가 계절(봄, 여름, 가을, 겨울)별로 동일한 비율인지를 검정하려고 신혼부부 200쌍을 조사하였다. 가장 적합한 가설검정 방법은?

  1. 카이제곱 적합도검정
  2. 카이제곱 독립성검정
  3. 카이제곱 동질성검정
  4. 피어슨 상관계수검정
(정답률: 32%)
  • 특정 변수(결혼시기)의 관측빈도가 이론적으로 기대되는 비율(계절별 동일 비율)과 일치하는지를 검정하는 것이므로 카이제곱 적합도검정이 가장 적절합니다.

    오답 노트

    카이제곱 독립성검정: 두 변수 간의 연관성 여부를 검정함
    카이제곱 동질성검정: 두 집단 이상의 분포가 동일한지 검정함
profile_image
1

*오류신고 접수시 100포인트 지급해드립니다.

< 이전회차목록 다음회차 >